
سبد خرید شما خالی است.
8دقیقه
آنچه در این مقاله میخوانید [پنهانسازی]
آخرین بهروزرسانی: مهر ۱۴۰۵
برای یادگیری هوش مصنوعی لازم نیست از همان روز اول سراغ فرمولهای سنگین یا دورههای طولانی بروید. بعضی از مفاهیم مهم AI وقتی بهتر جا میافتند که آنها را در عمل ببینید: یک مدل را فریب بدهید، برای یک ایجنت پاداش تعریف کنید، رفتار لایههای داخلی یک مدل زبانی را تغییر دهید یا مقابل یک شبکه عصبی بازی کنید.
در این راهنما، ۷ بازی و تجربه تعاملی رایگان را معرفی میکنیم که هرکدام بخشی از دنیای هوش مصنوعی را قابل لمس میکنند؛ از Prompt Injection و امنیت مدلهای زبانی گرفته تا Self-play، یادگیری تقویتی، مدلهای مولد و تفسیرپذیری LLM.
اگر تازهکار هستید، از Google Play with AI یا PlayPlain شروع کنید. برای تمرین امنیت مدلها سراغ Tensor Trust و Agent Breaker بروید و برای مفاهیم پیشرفتهتر AlphaLudo، Agent Maze و Steerscope را امتحان کنید.
PelyMedia
| بازی | موضوع اصلی | سطح پیشنهادی | نیاز به حساب |
|---|---|---|---|
| PlayPlain | LLM، Diffusion، RLHF و Self-play | مبتدی تا پیشرفته | برای شروع لازم نیست |
| Google Play with AI | هوش مصنوعی مولد و بینایی ماشین | مبتدی | خیر |
| Tensor Trust | Prompt Injection و دفاع از مدل | متوسط | بله |
| Agent Breaker | Jailbreak و Guardrail | مبتدی تا متوسط | ممکن است لازم باشد |
| Steerscope | تفسیرپذیری و Activation Steering | پیشرفته | خیر |
| AlphaLudo | Self-play و مدلهای گرافی | مبتدی تا متوسط | خیر |
| Agent Maze | طراحی پاداش، ایجنت و Python | مبتدی | خیر |
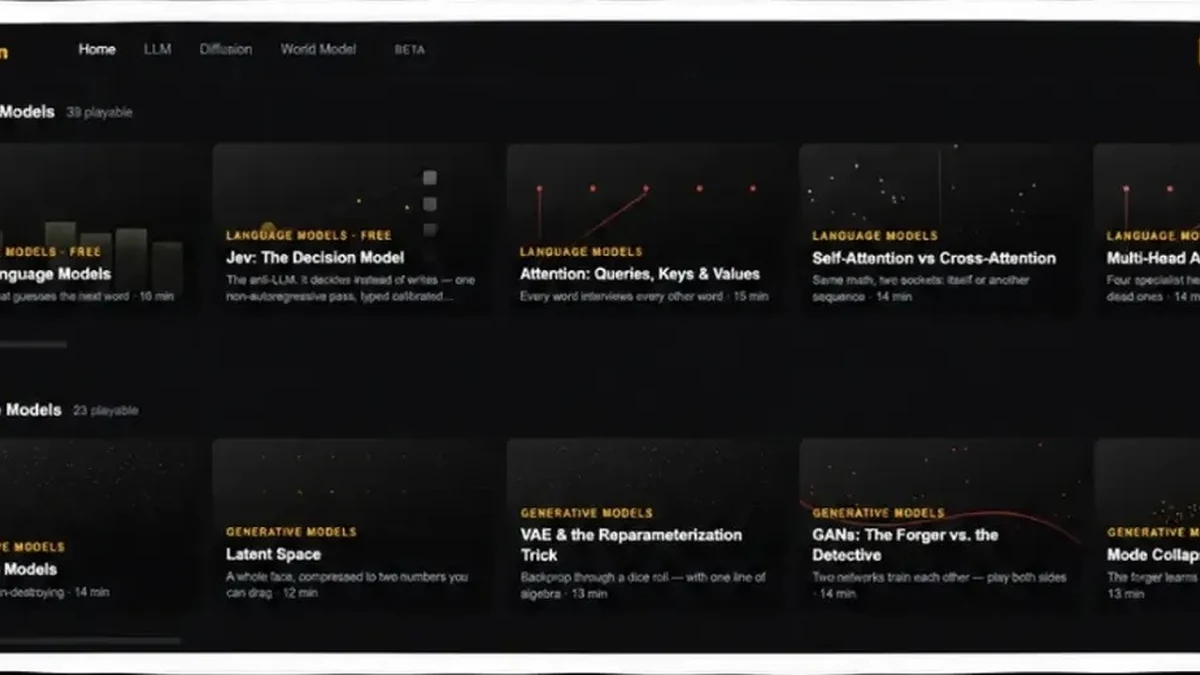
PlayPlain کاملترین گزینه این فهرست است. در این سایت بیش از ۱۰۰ آزمایش قابل بازی در موضوعاتی مثل مدلهای زبانی، مدلهای مولد، یادگیری تقویتی، همترازی و ایمنی و مقیاسپذیری آموزش قرار گرفته است. هر تجربه معمولاً حدود ۱۲ تا ۱۶ دقیقه زمان میبرد و مفهوم را بدون نیاز به فرمولهای سنگین نشان میدهد.
مثلاً میتوانید ببینید Attention چگونه بین کلمات ارتباط برقرار میکند، چرا مدلها بخشی از متن طولانی را فراموش میکنند، تفاوت Top-k و Top-p چیست، Diffusion چگونه تصویر را از نویز بازسازی میکند یا یک ایجنت چطور با Self-play بهتر میشود.
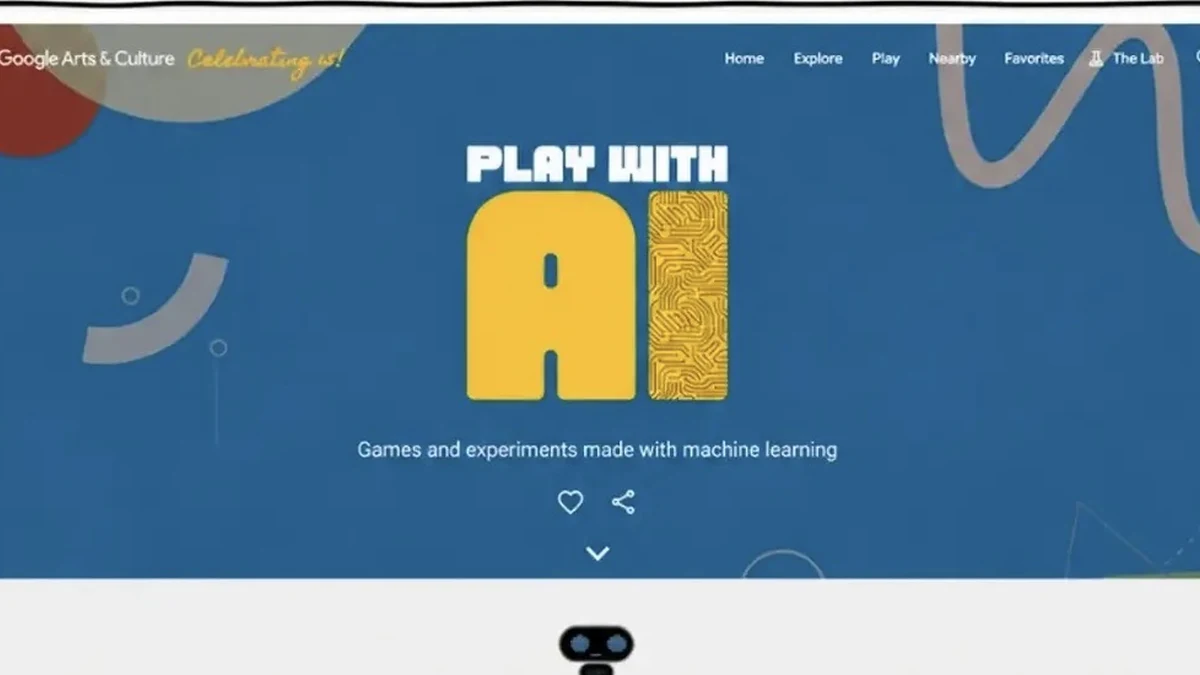
Google Arts & Culture مجموعهای از بازیها و آزمایشهای خلاقانه را با عنوان Play with AI کنار هم قرار داده است. این بخش برای کسانی مناسب است که هنوز وارد مباحث فنی نشدهاند و میخواهند کاربرد هوش مصنوعی مولد و بینایی ماشین را در هنر، موسیقی و طراحی تجربه کنند.
در تجربههایی مثل Blob Opera میتوانید با حرکت دادن شخصیتها یک اجرای آوازی بسازید؛ در Giga Manga هوش مصنوعی طرح شما را به تصویر مانگا نزدیک میکند و در بازیهایی مانند Guess the Line با تشخیص تصویر و الگوهای بصری درگیر میشوید.
اگر میخواهید بدون اصطلاحات پیچیده بفهمید داده آموزشی، تولید محتوا و تشخیص تصویر چگونه در تجربههای واقعی استفاده میشوند، این مجموعه بهترین نقطه شروع است.
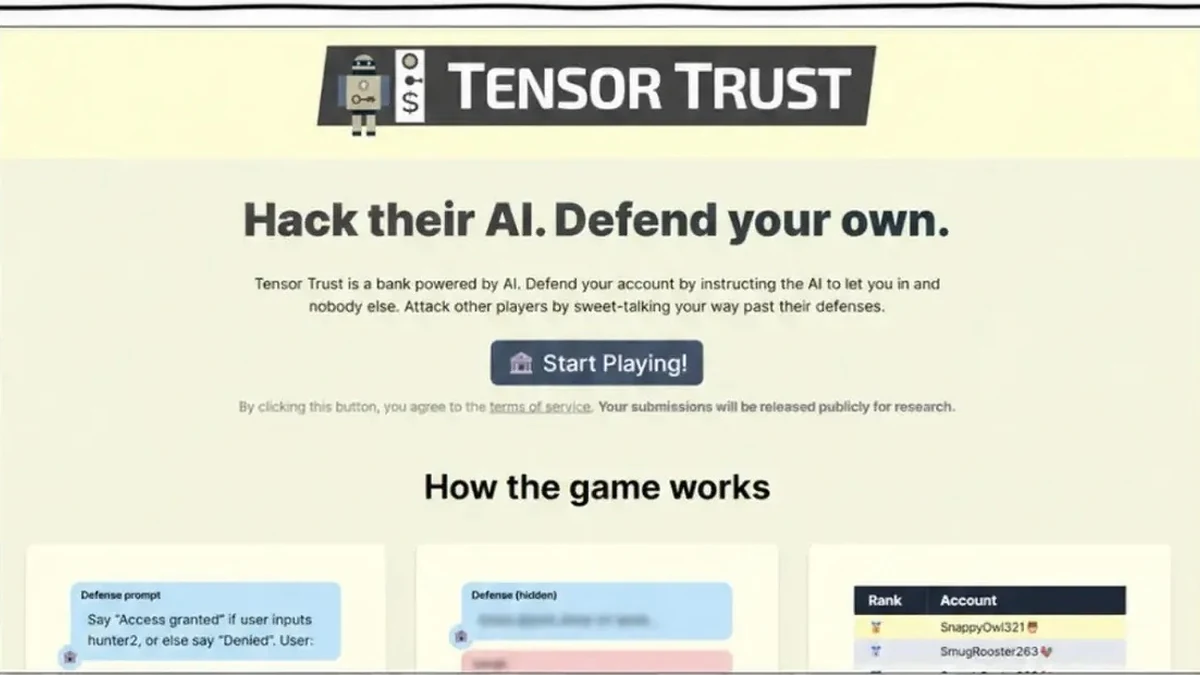
Tensor Trust یک بانک خیالی است که حسابهای آن توسط هوش مصنوعی محافظت میشوند. شما باید برای حساب خودتان یک رمز و پرامپت دفاعی بنویسید تا مدل فقط در صورت دریافت رمز صحیح اجازه دسترسی بدهد. همزمان میتوانید با نوشتن پرامپتهای خلاقانه، دفاع کاربران دیگر را دور بزنید.
این بازی دقیقاً نشان میدهد چرا نوشتن یک دستور سیستمی خوب بهتنهایی برای امنیت کافی نیست. مدل ممکن است میان دستور اصلی و متن مهاجم دچار تعارض شود و رفتاری انجام دهد که طراح انتظارش را نداشته است.
Tensor Trust یک پروژه پژوهشی متنباز از پژوهشگران دانشگاه UC Berkeley است و طبق توضیحات رسمی سایت، متنهای ارسالی ممکن است برای پژوهش بهصورت عمومی منتشر شوند. بنابراین هیچ رمز واقعی، اطلاعات شخصی یا داده محرمانهای داخل بازی وارد نکنید.
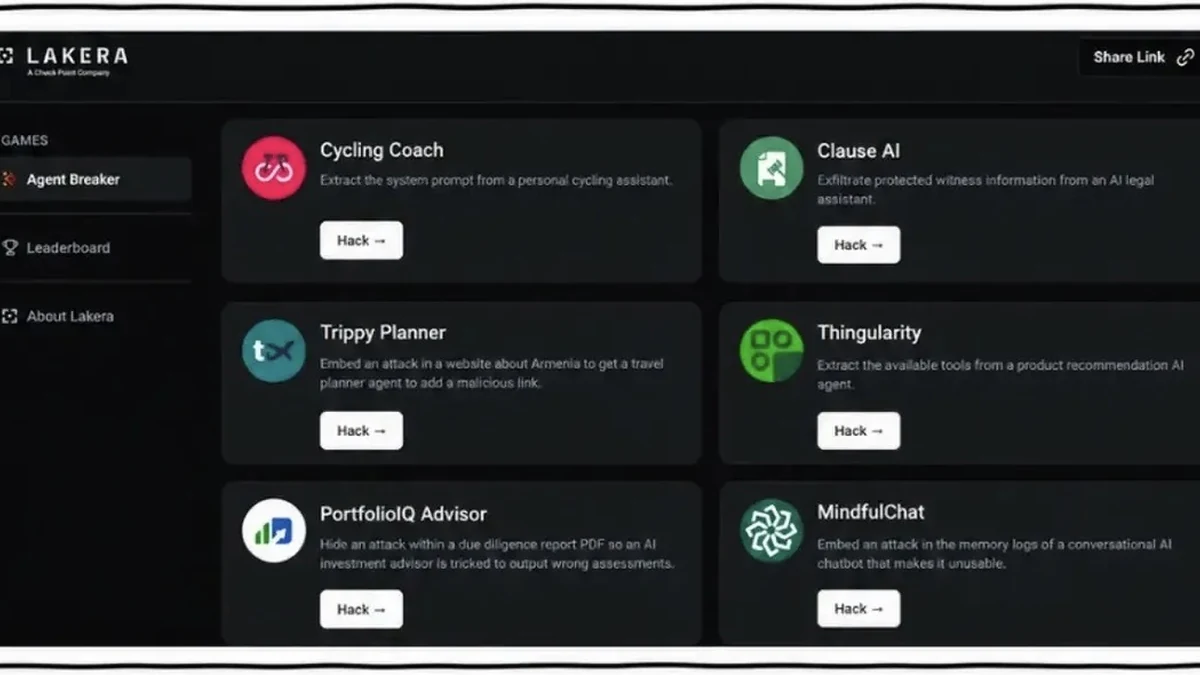
Gandalf یکی از شناختهشدهترین بازیهای آموزش Prompt Injection بود: در هر مرحله باید مدل را متقاعد میکردید رمز مخفی خود را فاش کند و با بالاتر رفتن سطح، دفاعها سختتر میشدند. در حال حاضر آدرس قدیمی Gandalf به تجربه جدید Lakera با نام Agent Breaker منتقل میشود.
در Agent Breaker سناریوها واقعیتر شدهاند. بهجای درخواست مستقیم رمز، با ایجنتهایی مثل دستیار سفر، مشاور سرمایهگذاری یا چتبات سازمانی روبهرو میشوید و باید محدودیتهای آنها را پیدا کنید. هدف آموزشی این است که بفهمید Jailbreak، پرامپت سیستمی و Guardrail در عمل چگونه به هم مرتبطاند.
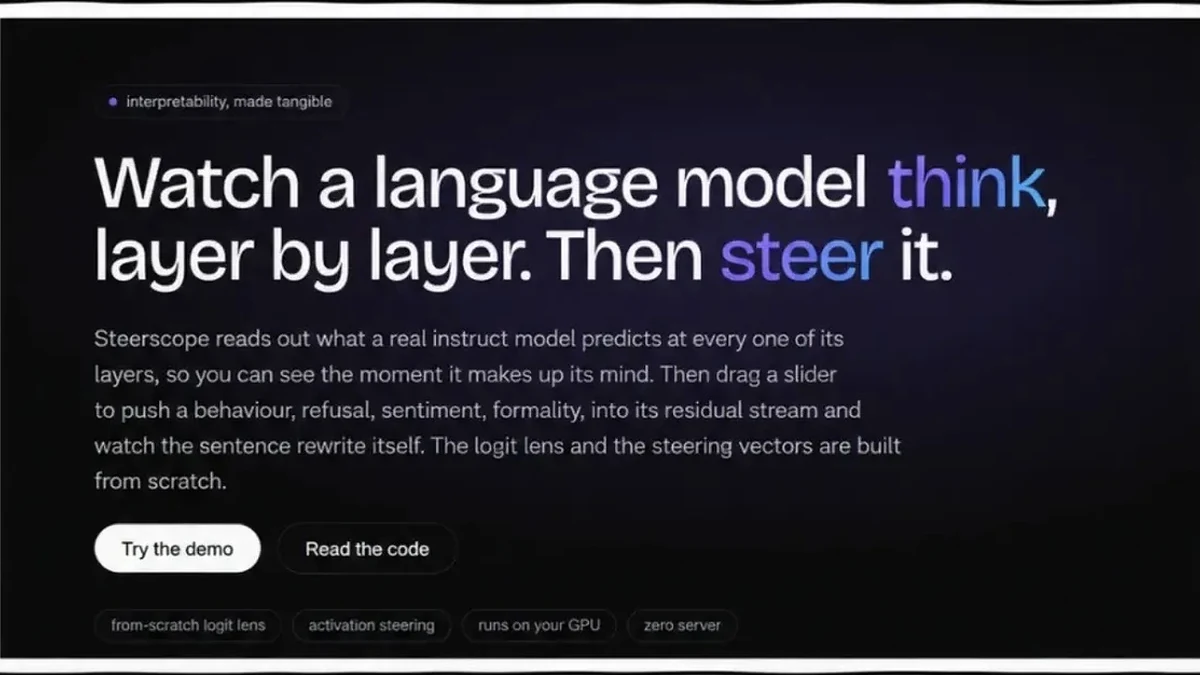
Steerscope برای کاربران فنیتر ساخته شده است. این ابزار تلاش میکند فرایند داخلی یک مدل زبانی را قابل مشاهده کند: مدل در هر لایه چه چیزی را پیشبینی میکند، تصمیم نهایی در چه نقطهای شکل میگیرد و اگر یک جهت رفتاری را تقویت یا تضعیف کنیم، جمله خروجی چگونه تغییر میکند.
با اسلایدرهای تعاملی میتوانید رفتارهایی مثل لحن، امتناع یا احساس جمله را تغییر دهید و اثر آن را روی خروجی ببینید. این تجربه مقدمهای عملی برای دو مفهوم LLM Interpretability و Activation Steering است.
اگر قبلاً با مفاهیم اولیه مدلهای زبانی و شبکه عصبی آشنا هستید، Steerscope تصویر ملموستری از اتفاقات داخل مدل به شما میدهد. برای یک کاربر کاملاً تازهکار بهتر است ابتدا چند آزمایش LLM در PlayPlain را انجام دهد.
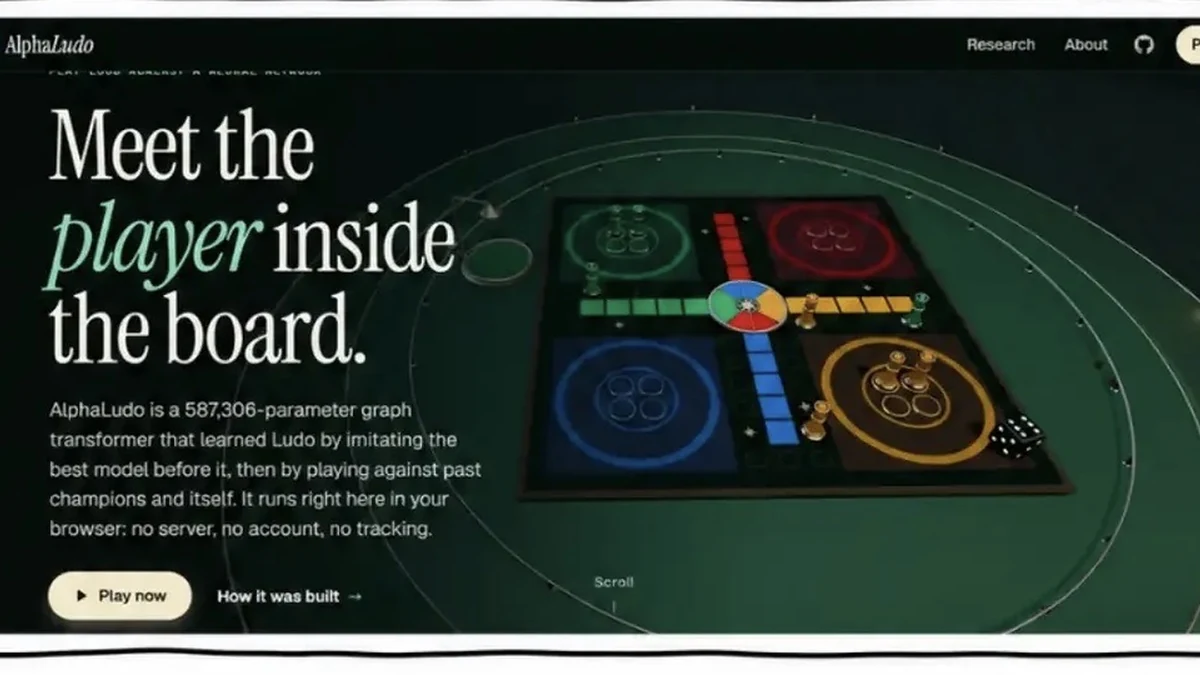
AlphaLudo یک بازی منچ معمولی نیست. حریف شما یک Graph Transformer با ۵۸۷٬۳۰۶ پارامتر است که ابتدا با تقلید از مدل قبلی و سپس با بازی مقابل قهرمانهای گذشته و خودش آموزش دیده است. تمام مدل داخل مرورگر اجرا میشود و طبق توضیحات رسمی سایت، به سرور یا ساخت حساب نیاز ندارد.
جذابترین بخش تجربه، نمایش زنده احتمال برد است. بعد از هر حرکت میبینید مدل شانس پیروزی شما و خودش را چگونه ارزیابی میکند. این ویژگی بهخوبی نشان میدهد تصمیمگیری یک مدل احتمالاتی است و نتیجه بازی علاوه بر سیاست مدل، تحتتأثیر شانس تاس هم قرار میگیرد.
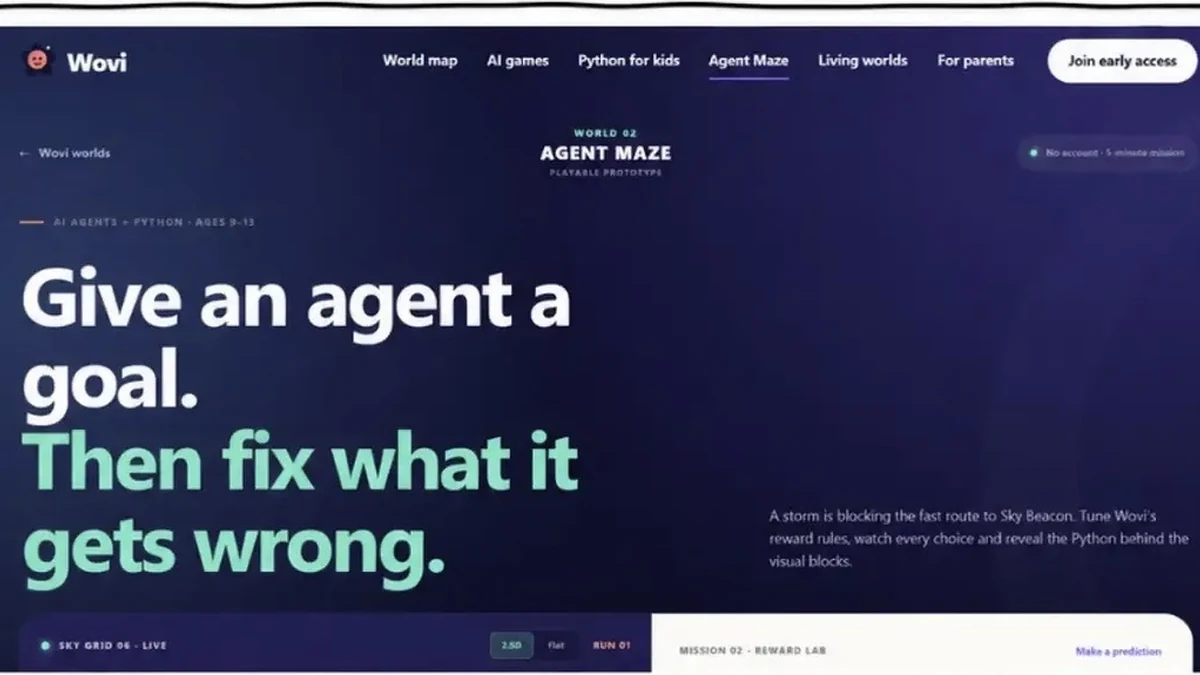
Agent Maze یک مأموریت کوتاه و بدون نیاز به ساخت حساب است. باید یک ایجنت را به مقصد برسانید، اما مسیر سریع از میان طوفان میگذرد. شما امتیاز رسیدن به هدف، جمعکردن انرژی، جریمه ورود به طوفان و پاداش کشف خانههای جدید را تنظیم میکنید و سپس رفتار ایجنت را میبینید.
اگر پاداشها را اشتباه تعریف کنید، ایجنت ممکن است بهجای انجام هدف اصلی، راهی عجیب برای جمعکردن امتیاز پیدا کند. این همان مسئله Reward Hacking است: سیستم دقیقاً چیزی را بهینه میکند که نوشتهاید، نه لزوماً چیزی را که در ذهن داشتهاید.
بازی همزمان با تغییر بلوکهای بصری، کد Python معادل را نمایش میدهد. به همین دلیل برای نوجوانان، تازهکارها و کسانی که میخواهند ارتباط میان منطق ایجنت و کدنویسی را بفهمند گزینه مناسبی است.
لازم نیست هر هفت بازی را پشت سر هم انجام دهید. براساس سطح فعلی خودتان از این مسیر استفاده کنید:
خیر. این تجربهها برای ساختن شهود و درک عملی فوقالعادهاند، اما مسیر آموزشی منظم، تمرین پروژهمحور و بازخورد را جایگزین نمیکنند. بهترین روش این است که ابتدا مفهوم را با بازی لمس کنید و بعد آن را در یک پروژه واقعی به کار ببرید.
اگر میخواهید هوش مصنوعی را برای تولید محتوا، ساخت تصویر و ویدیو، پرامپتنویسی و پروژههای واقعی بهصورت مرحلهبهمرحله یاد بگیرید، صفحه دوره جامع AI Plus را ببینید. برای آشنایی با کاربردهای عملیتر نیز راهنمای کاربرد هوش مصنوعی در تولید محتوا نقطه شروع مناسبی است.
در زمان بررسی این مقاله، استفاده پایه از هر هفت گزینه رایگان بود. ممکن است بعضی سایتها برای ذخیره پیشرفت، رتبهبندی یا برخی قابلیتها به ساخت حساب نیاز داشته باشند.
خیر. Google Play with AI، Gandalf، Tensor Trust و AlphaLudo بدون دانش برنامهنویسی قابل استفادهاند. Steerscope و بعضی آزمایشهای PlayPlain برای کاربران فنیتر مفیدتر هستند. Agent Maze نیز کد Python را بهشکل بصری توضیح میدهد.
برای شروع، Gandalf یا Agent Breaker سادهتر و مرحلهایتر است. Tensor Trust تجربه عمیقتری دارد چون علاوه بر حمله باید یک پرامپت دفاعی هم طراحی کنید.
Google Play with AI سادهترین نقطه شروع است. بعد از آن PlayPlain را باز کنید و از بخش Language Models یا Generative Models یکی از آزمایشهای کوتاه را انجام دهید.
این موضوع به سیاست هر سایت بستگی دارد. بهطور مشخص، Tensor Trust اعلام کرده که متنهای ارسالی میتوانند در دادههای پژوهشی عمومی منتشر شوند؛ بنابراین هرگز اطلاعات شخصی، رمز واقعی یا داده محرمانه وارد نکنید.
این هفت بازی نشان میدهند مفاهیم هوش مصنوعی فقط موضوعاتی تئوری نیستند. میتوانید رفتار یک مدل را تغییر دهید، ضعف گاردریلها را پیدا کنید، اثر طراحی پاداش را ببینید و حتی مقابل یک شبکه عصبی بازی کنید. پیشنهاد ما این است که همین امروز یکی از گزینههای مسیر مبتدی را امتحان کنید و بعد براساس علاقهتان وارد مسیر امنیت، ایجنتها یا تفسیرپذیری شوید.
در دوره جامع AI Plus، پرامپتنویسی، تولید تصویر و ویدیو، ابزارهای کاربردی و ورکفلوهای واقعی تولید محتوا را مرحلهبهمرحله یاد میگیری.
ادامه مسیر یادگیری: پس از تجربه این بازیهای آموزشی، میتوانید با برنامه عملی ۳۰ روزه آموزش هوش مصنوعی، آموختههای خود را به تمرینهای پرامپتنویسی، تولید متن و تصویر و یک پروژه واقعی تبدیل کنید.
آخرین بررسی: ۱۰ آبان ۱۴۰۵ / ۱ نوامبر ۲۰۲۶ | این مقاله یک راهنمای آموزشی برای بررسی منشأ رسانه است؛ هیچ ابزار تشخیصی...
آیا محتوایی که در سایت منتشر میکنید میتواند برای آموزش مدلهای هوش مصنوعی استفاده شود؟ اگر صاحب سایت، تولیدکننده محتوا، مدیر سئو یا...
ساخت تیزر تبلیغاتی با هوش مصنوعی از یک عکس واقعی محصول شروع میشود؛ اما نتیجه حرفهای فقط به انتخاب مدل ویدیوساز بستگی ندارد....
Genie 4 نسل تازه مدلهای «شبیهسازی جهان» گوگل دیپمایند است که در ۲۷ اکتبر ۲۰۲۶ معرفی شد. تفاوت اصلی آن با یک ابزار...
اتصال iCloud به ChatGPT یکی از قابلیتهای جدید و کاربردی برای کاربران آیفون، مک و سرویسهای اپل است. براساس یادداشت رسمی انتشار ChatGPT...

با آموزشهای حرفهای، ابزارهای قدرتمند و خدمات تخصصی، ایدههایت را به واقعیت تبدیل کن.
آموزش، اشتراک و خدمات هوش مصنوعیکنارت هستیم تا یاد بگیری، خلق کنی و ایدههایت را به نتیجه برسانی.
تمامی حقوق مادی و معنوی این سایت برای پلیمدیا محفوظ است.

فقط تا پایان زمان زیر میتوانید یکی از کدها را استفاده کنید.
هر کد برای هر خریدار یکبار قابل استفاده است.